图像多标签分类实验
“遥感图像多标签分类实验的学习记录:数据处理、模型搭建与消融实验。”
在实验之前,我们需要清晰的知道目前做的是对哪些图片进行分类,语义很大程度上会影响判断与处理 遥感图像特点:
- 上帝视角,很适合使用翻转甚至旋转
- 尺寸差异极大,裁剪容易失去部分特征
- 高度依赖上下文:-
baseball_diamond(棒球场)和tennis_court(网球场)长得很像,但棒球场有特定的内野红土和扇形结构。harbor必须有水和陆地的交界。bridge必须横跨水面或道路
对于一个图像分类问题,主要分为一下几个步骤:
- 数据处理
- 搭建完整模型,跑通流程
- 做消融实验,调参
我们下面就从数据处理开始: 目录中的train和test分别存放着训练集和测试集,其中训练集包含图片及其一些相关信息,其中包含了每张图片的标签,而测试集中只包含图片。【这里需要注意,为了检测泛化能力以及后续的调参,我们需要一个验证集,但是这里并没有给出对应的验证集,这意味着我们需要从训练集中拆分出验证集,不过这也是后面的事情了】
先复习JSON相关转换 -> JSON,JSON要转换成DataFrame,这样做的原因是为了便于分析与获得数据,同时便于数据分析和画图
annotations_classification.json
数据需要检测,需要设计json的防御性检测,主要往:
- 结构与字段,需要关注关键的键是否存在
- 数据规模
- 数据的类型与格式
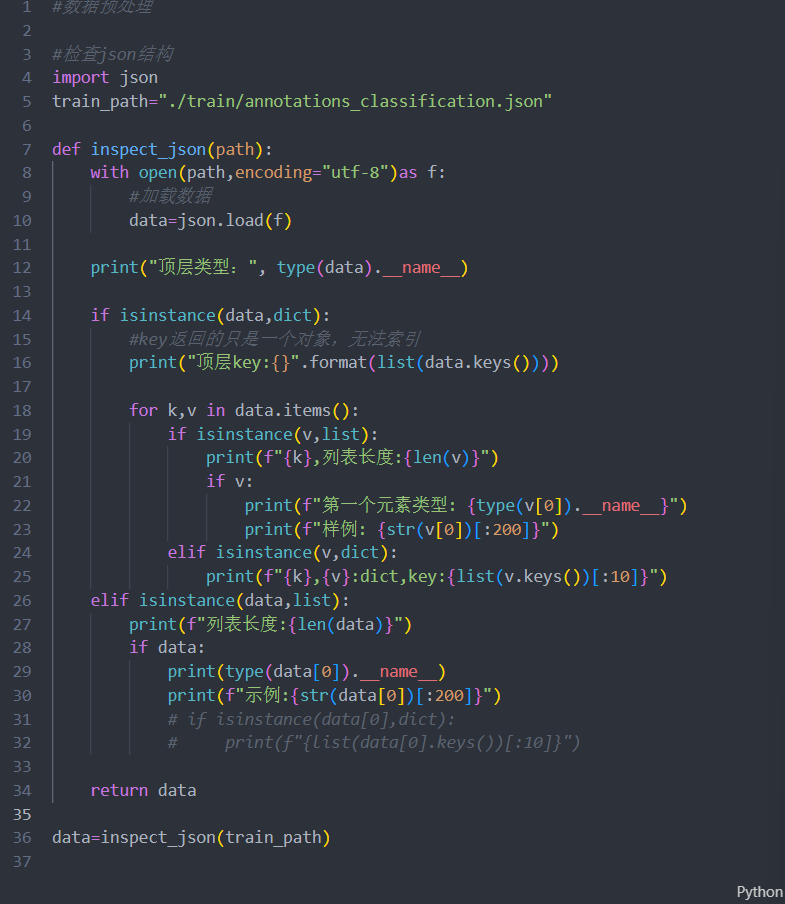
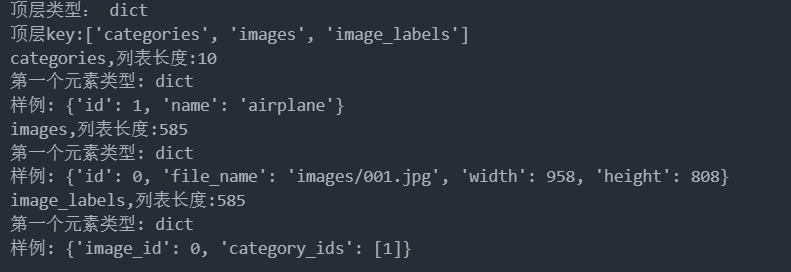
由输出可以知道该json提供了’categories’, ‘images’, ‘image_labels’相关信息,且一共有585张照片 提醒:使用type时,可以用__name__,可以让输出的内容更干净整洁
数据预处理
检查好数据后,如果是dict,可以直接转dataframe,同时要做好检测
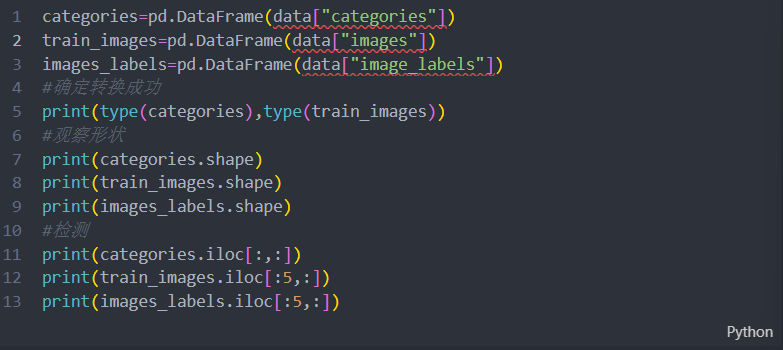
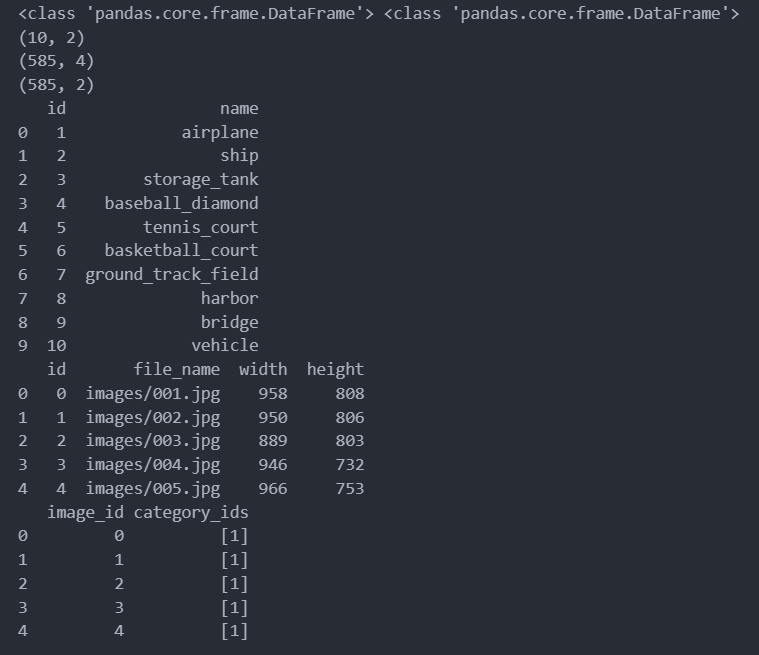
可以观察到图片给出了 file_name 这个信息,且前面已经包了一层 images,这是要注意的细节,后面写 train.dir 就不要再加 images。 对于 width 与 height 等相关数据,要进行数据检查和数据清晰,尽管这次其实没有必要清洗 ->可看这里: 接下来就是要将数据进行拼接与处理:
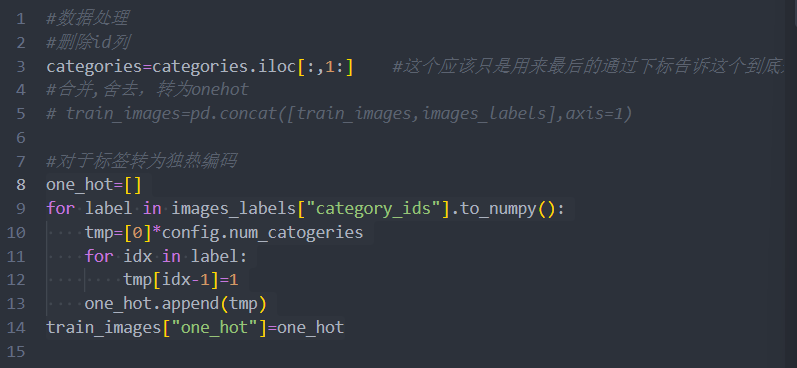
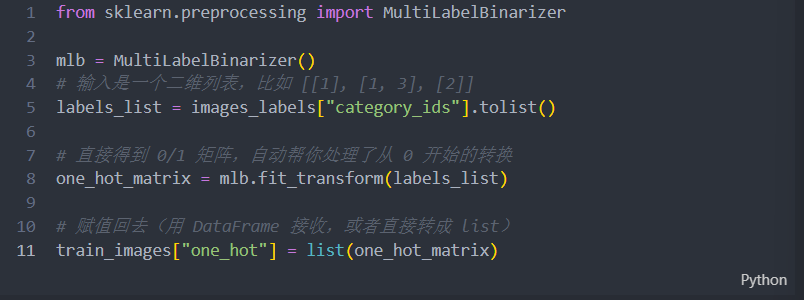
这里进行了删除多余的列和标签的 one-hot处理,但是复盘时发现这种做法不仅慢且一旦索引对不齐就会导致乱序,因而给出新的改法:
调用sklearn库封装好的函数,专门处理多标签 One-Hot,不过要注意的是最后不要将numpy数组直接塞入,可以转成 Series 或者 list。而对于索引的排序问题,建议
train_images = train_images.reset_index(drop=True)
下一步的工作就是对图片的分析,由于图片的 width 和 height 基本不同,所以要进行处理,这里一开始走了弯路,误以为要裁剪至同一尺寸,但是直接裁剪会损失大量信息,因而使用别的方法。但是这一步可以了解图片的大概信息,不过可以直接用 pd 中的 describe()
这里介绍几种统一照片尺寸的方法: 拉伸
#如果size参数只传224,短边缩到224,长边会压缩
torchvision.transforms.Resize((224,224)),
缩放 + 中心裁剪
    torchvision.transforms.Resize(256),
    torchvision.transforms.CenterCrop(224),
随机抽取比例 + 拉伸
torchvision.transforms.RandomResizedCrop(224,scale=(0.8,1.0))缩放 + 填充(需要自己实现)
class ResizeWithPad:
    def __init__(self, size=224, fill=0):
        self.size = size
        #填充的颜色
        self.fill = fill
        #使用call,使得实例可以像函数一样被调用
    def __call__(self, img):
        w, h = img.size
        # 等比例缩放:让最长边变成 size
        scale = self.size / max(w, h)
        #像素不能有小数
        new_w = round(w * scale)
        new_h = round(h * scale)
        #`torchvision` 的 `Resize` 接收的参数顺序是 `(高, 宽)`
        img = torchvision.transforms.Resize(
            (new_h, new_w),
            #做了平滑过渡——双线性
            #马赛克化
            #interpolation=T.InterpolationMode.NEAREST
            interpolation=torchvision.transforms.InterpolationMode.BILINEAR
        )(img)
        # 计算四周填充量
        pad_left = (self.size - new_w) // 2
        pad_top = (self.size - new_h) // 2
        pad_right = self.size - new_w - pad_left
        pad_bottom = self.size - new_h - pad_top
        img = torchvision.transforms.Pad(
            (pad_left, pad_top, pad_right, pad_bottom),
            fill=self.fill
        )(img)
        return img

ResizeWithPad(224,0),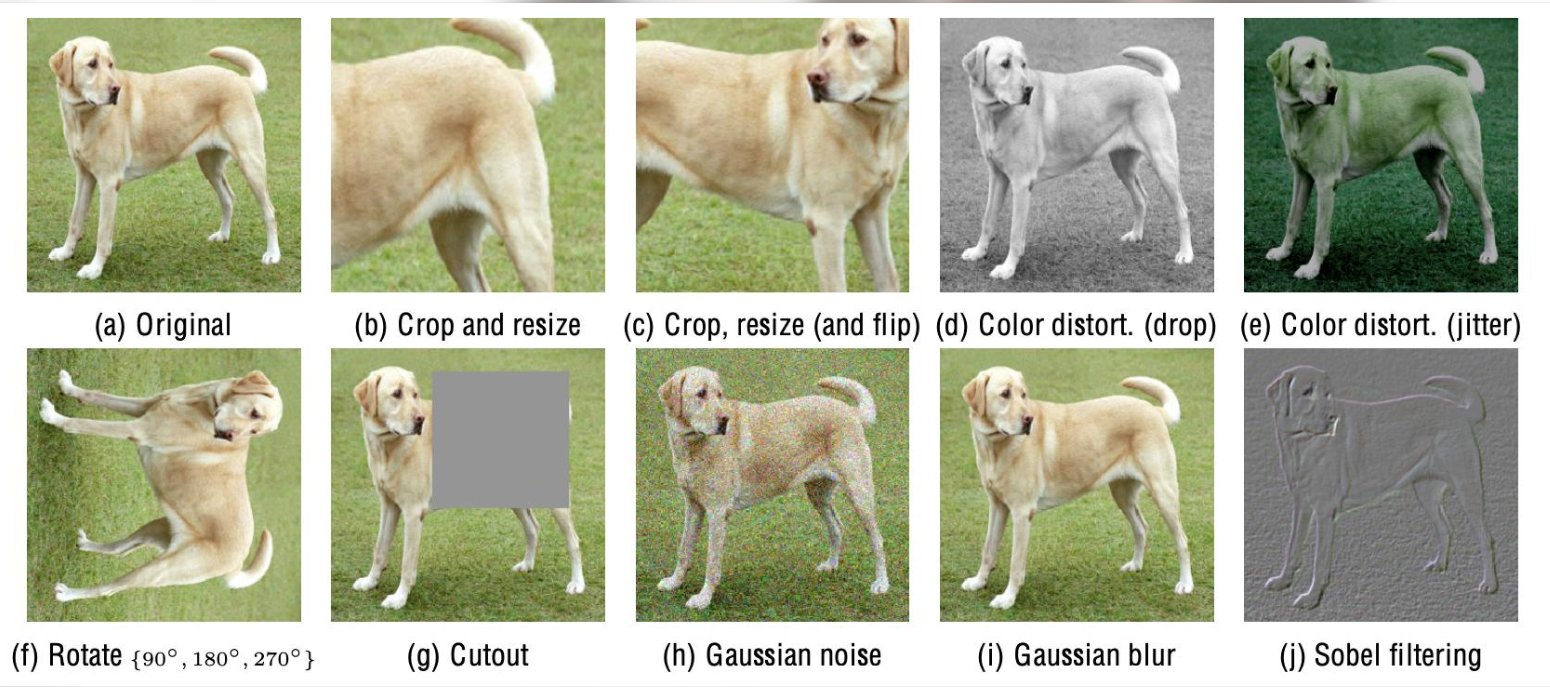
不同的图片统一尺寸不同效果,可以使用对比实验验证。还要注意的是,这只是对训练集进行处理,且可以看到其中的随机裁剪存在随机性,在处理验证集和测试集的时候可能不应该引入随机性:
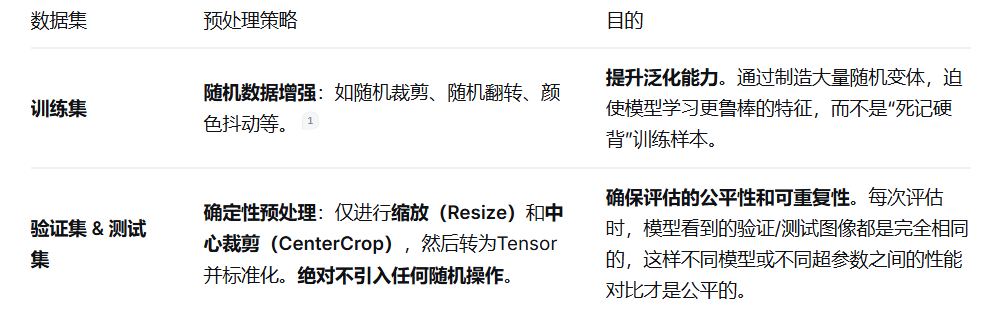
经过查阅,当使用预训练模型时,最好的方法是取该模型的某个权重的对应的预处理操作,可以直接应用在测试集和验证集,而对于训练集可以在使用前,加上所需要的强数据增强的手段。所以不要为了验证正确性而过多的做所谓的为正确性验证做的消融实验。 但是经下文发现,对于遥感数据可能不太适用中心裁剪,要尽可能的保留上下文,所以可以以社区标准作为baseline 1,再新开一个训练集测试集验证集都用 pad 来处理大小尺寸的 baseline 2 ,注意,这不是做一组消融实验,而是一定要保证训练集和测试集有统一的处理方式,如果交叉时候中心裁剪模型认不出为什么周围有填充的特征
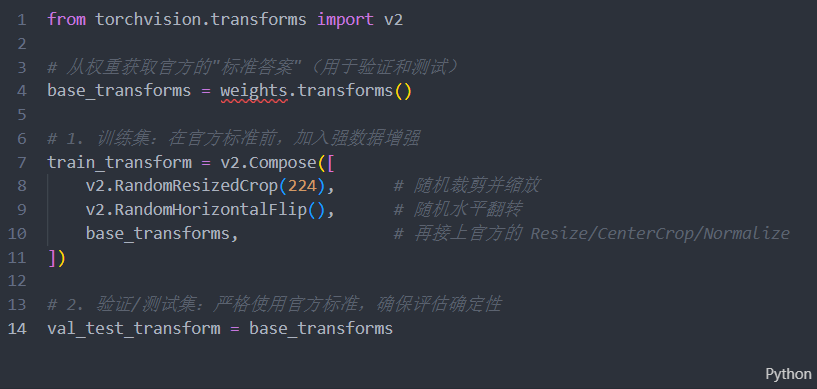
这里拿 model = models.resnet18(weights=models.ResNet18_Weights.IMAGENET1K_V1) 对应的预处理操作作说明:
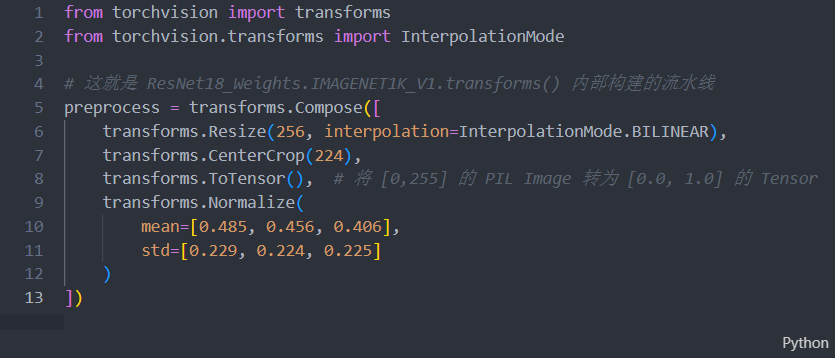
Totensor包含了数值缩放,Normalize将数据处理成正态分布
同意好尺寸还可以做数据增强,其选择的标准是:增强处理后,图片标签不变,语义不发生改变
而对于本次实验,多指标遥感图像分类问题(Remote Sensing Scene Classification),需要注意的是是否引入了“标签噪声”——即变换后,某些原本存在的物体消失了,或者出现了不该有的新物体,而我们本次实验选用的模型是基于 ImagesNet 训练的 ResNet 框架的 model ,其一般都是对平视的图片分类,对于这种遥感俯视的图片不一定符合。尽管如此,在查阅中,如果只用模型的框架,在如此小的数据集上跑,很容易过拟合,所以正常操作是沿用预训练模型的框架和权重
所以这里可以尝试一下的数据增强:(只在训练集上使用) 空间几何增强,颜色方面的处理(具体做 baseline 判断)
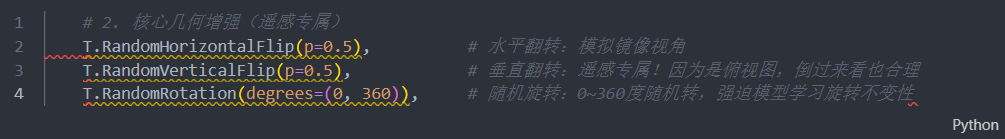
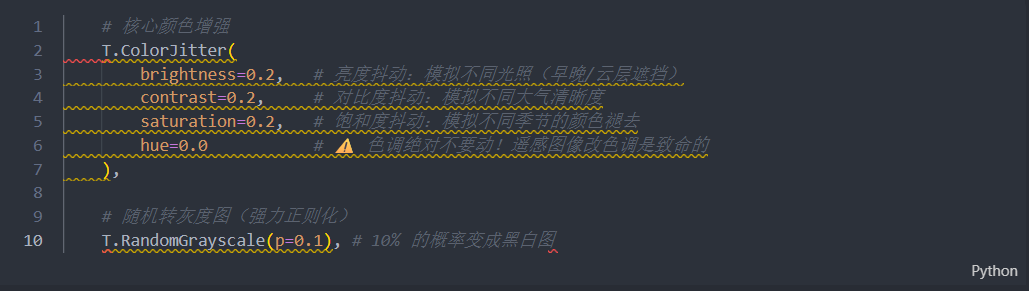
到此,完成数据的预处理,下面就是进入数据的装载以及进入正式的训练
因为没有要拆分训练集和验证集,所以需要自定义dataset,其要求就是要能满足长度和下标访问
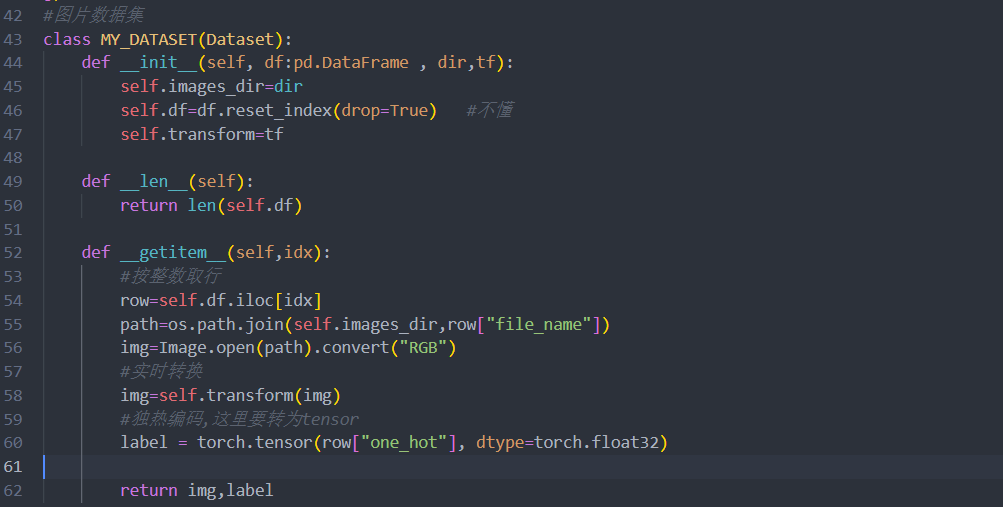
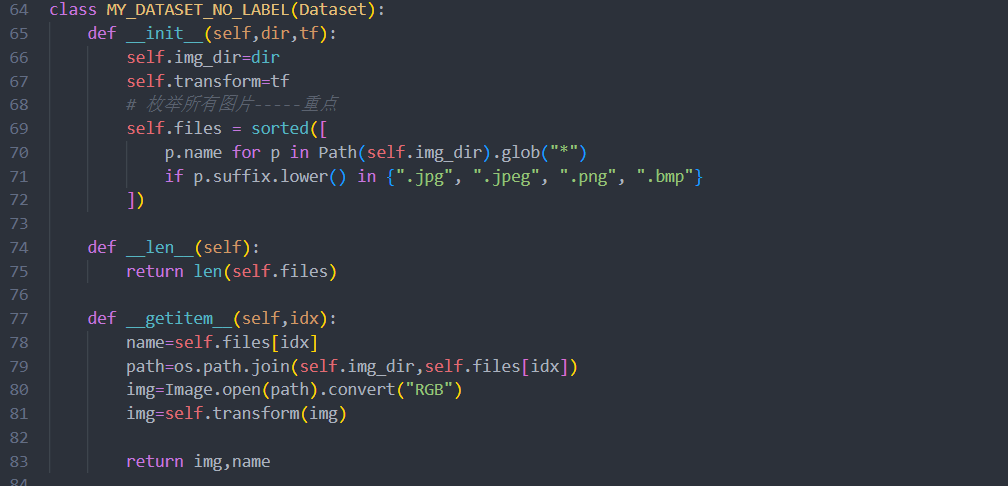
接下来就是导入模型和配置好gpu,可能需要注意的就是记得修改模型的最后一层 该实验选用的是多标签常用的BCE损失函数,指标使用Macro-MAP评估,优化器使用Adam 且用了lr的测试器选择下降最稳定的lr,并引入了epoch的早停 使用k折实验,并做了模型集成
最终测试集上的结果如下(不过这个是用了少量数据增强和中心裁剪,只做了预处理的消融实验,还有 Dropout和 weight decay 的正则化避免过拟合。前期还没弄懂到底怎么做baseline,但是我已无意再炼,该玩玩其他了)

总结一下,这其中代码其实包含了很多,很多时候都是在做数据的处理和消融实验,以及调参,说到调参,这里也重点说一下,一开始打好一条baseline后,不应该立马去预处理消融,应该先调 lr 和 epoch ,不过这里我直接用了 lr finder 和 Early Stop ,所以提前找好并调好,但是这种方法不一定奏效,但是能很快的到达较好的参数,避免一开始设置 lr 为0.1,loss从 10的5次方一直降,而我却一直在调预处理,实则模型欠拟合。所以要注意调参的顺序。还有画图和记录数据也是一件很重要的事情,这方面还是工程上处理的不够好。还有就是目前因为用了预训练模型,出来的loss曲线其实是有点奇怪的,变化比较大,大概是因为lr过大,batch_size过小,数据增强过猛,没有使用学习率衰减等原因造成
所幸的是助教给你测试结果还不错