transformer
“初识大模型”
因为要做 assignment 时需要借助 transformer 的框架来做图生文,因此借助一些知乎和 3Blue1Brown 以及一些小红书的帖子学习了该框架
参考资料:
在写这篇 transformer 之前,先简述一下这个玩意到底在解决什么。
对于传统的时序模型,比如 RNN ,在处理长时序的时候往往会大量丢失前面的信息,且无法并行计算,进而有了 transformer 的诞生。最经典的架构是 Encoder-Decoder (典型的中英文翻译),当然还有 BERT 的 Encoder-only (用于做阅读理解),还有当下火热的生成式AI,即 ChatGPT 的 Dncoder-only 。目前 transformer 已经有多种变体,此文主要学习最经典的 Encoder-Decoder 架构和 Decoder 架构。
初次写这篇文章时,我急于对 Encoder 和 Decoder 做出一个清晰的解释,但当了解了上面的三大架构后,我意识到必须在具体的架构去谈及其功能及解释,因此,本文会从三个架构按顺序来解释。
Encoder-Decoder
此架构适合解决输入与输出在模态、长度或语言体系上差异巨大,且需要精确映射的问题。例如:机器翻译、语音识别、图像描述生成、文本摘要等
先总体理解架构:Encoder-Decoder
以“中文翻译英文”为例
- Encoder(中文阅读理解):接收 10 个中文词,经过自注意力机制(无 Mask 遮挡),提取出全句的终极语义矩阵 CC(形状
[10, 512])。 - Decoder(双重身份的同声传译):它接收两路信息:一路是 Encoder 传来的中文语义 CC;另一路是自己刚生成的英文序列(比如 4 个词的
<START> I love)。 进入 Decoder 后,会经过两次截然不同的 Attention:
- 第一层:Masked Self-Attention(英文内部消化)。Q、K、V 全来自英文。它通过 Mask 遮住未来,让英文自己理解自己的语法进度。(此时 Q 形状
[4, 512])。 - 第二层:Cross-Attention(中英跨语言对接)。Q 来自英文(我当前需要一个动词),K 和 V 来自中文(原句里有什么词能匹配?)。
下面则是一步步来讲:
拿中英文机器翻译来举例。对于人类语言,我们可以给每个词打上唯一的编号。比如,把奶龙编号为 1026,豆姐编号为 1025。但是这样的处理会导致模型去学习的时候,学习到豆姐<奶龙,但是这样的关系却无法体现词与词之间的关系。One-Hot 编码貌似能解决这个问题,但是它的稀疏性在高维空间无异于灾难,且两个词的点积为0,无法计算相似度。所以,这里使用一种方法:Embedding (词嵌入)。
Embedding :把离散的符号(词、子词、字符,甚至是图像切分的 patch),映射成一个可学习的稠密连续向量。
首先,建立一个查表矩阵 , V是词表的大小,d是嵌入的维度,即在 d 维空间的一个向量来表示一个词。这里不需要做矩阵乘法,只需要找到对应编号行,取出来即可。需要注意的是,此时的 查表矩阵 是随机生成的,不具备任何的语义,当然,它是后面反向传播的优化对象,这里暂时留一个谜点(会涉及到权重共享)。
有了上述的方法,我们可以对模型进行输入。 输入:姚明非常会打篮球,拆分成 token 即 姚明 非常 会 打 篮球 ,得到一个 的矩阵,其中行向量即对应token的向量。但是这样的表示仍有漏洞,即缺乏位置注意,在后续的计算内积时,“篮球非常会打姚明”和原句的内积是一致的,因而需要加上位置编码,其公式如下:
:词在句子里的绝对位置(0, 1, 2…) :词向量的总维度(比如 512) 和 :代表维度的索引 (这里是有一些相对位置和低维记录精确位置,高维粗略记录,但是这里我没太弄没明白,但是确定的是加入了位置的信息)
完成后,模型的输入 X 就确定了,进入模型后需要将信息输入 Attention 模块中,由于这里是多头注意力,这里简化先讲清楚单头注意力。
先贴出最重要的公式:
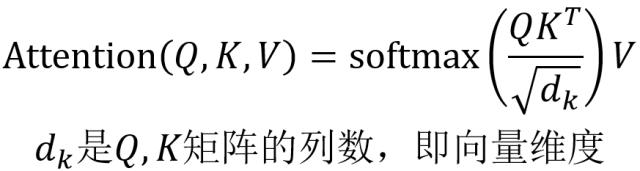
对于输入 X ,先随机初始化三个矩阵 , , 。接下来会进行一下操作: , ,因为是单头注意力,因而, 和 的形状是 。这样的操作可以看成将一个空间映射到另一个空间,不过这两个空间的维度都是一样的所以是同一片区域但是基向量发生了改变,之所以这么做,是因为不同的语义其实是空间中的某片区域,这样的映射便于反向传播不断调整映射的空间,使得 Q 进入一个语义的空间。这里很显然可以看出如果是单头的时候,占内存大,且在原空间不进行压缩的寻找,寻找出来的特征单一,这样是难以训练,因此有了多头注意力,下面来讲8头注意力。
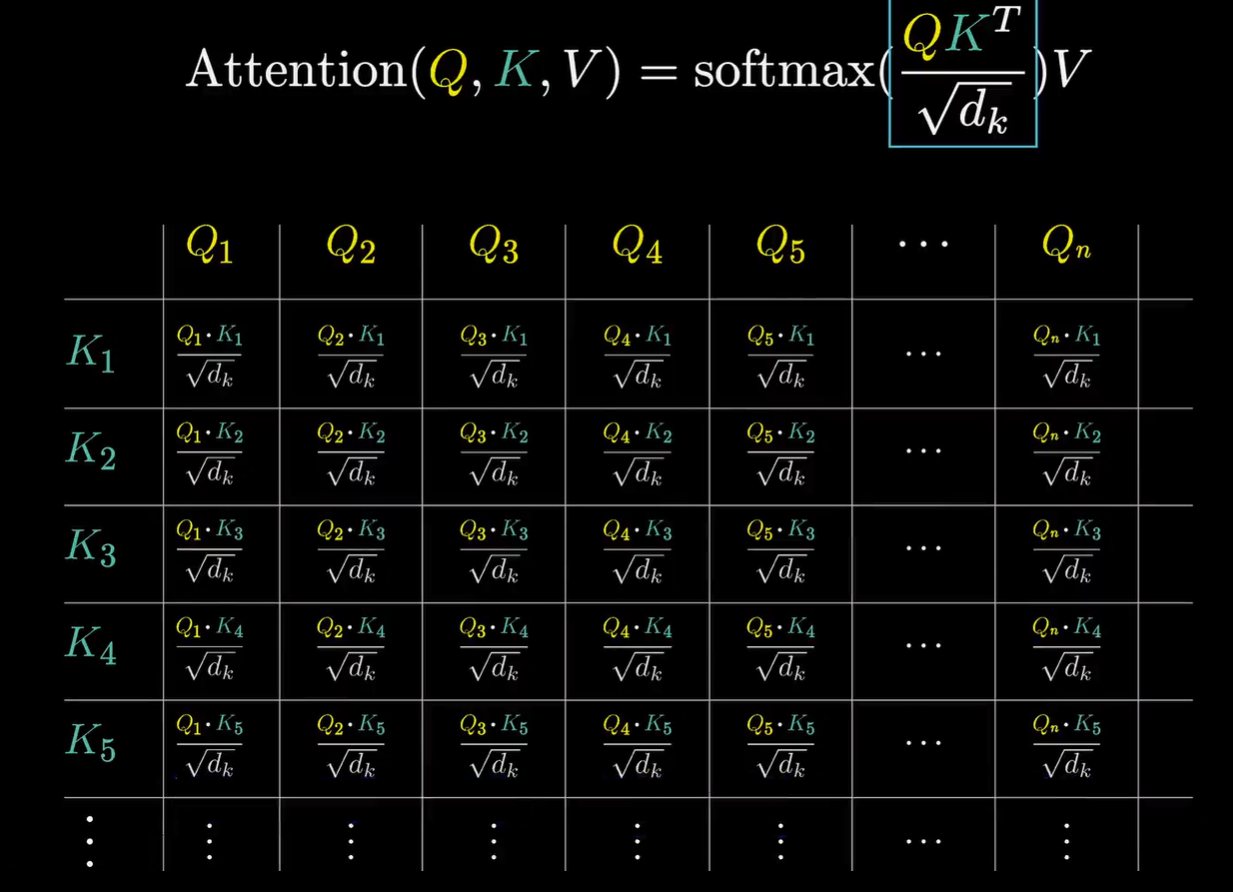
此时 和 的形状是 。对于单个注意力模块,得到 和 的形状为 即每个词将自己的512维的信息压缩到了一个小的空间,此时该空间是随机的,不具备任何语义。回到公式 , ,形状为 ,转置加矩阵乘法的操作其实就是 token 之间做点积,算出来的值即相关性,后续做 操作进行概率归一化,矩阵的第 i 行代表第 i 个词对全句其他词的相似度打分。继续回到公式:
,这里的 形状为 , 形状为 ,即每个词经过随机压缩后映射到了更小的一个语义空间,而公式中进行矩阵乘法其实就是相似度概率与值相乘,即对于某个 token ,其值根据相似度汇总了所有词的一些信息,进而得到输出 ,形状为 ,其含义为随机语义空间且吸收了其他词的语义后,token 的新的表示。而8头注意力即要将8个 拼接成 ,其形状为 ,与输入形状一致。此时合并后的矩阵其含义为每部分都是不同语义空间下词的特征,尽管没有反向传播前是没有意义的。接下来,要乘以一个 ,形状为 即对不同语义下的特征进行加权,使得每个特征有了不同的语义混合,当然 是一个可训练的权重。完成这些后,加上 ,使得每个词同时拥有融合语义信息也保留了其本身的信息,即残差连接,使得反向连接时可以迅速调整 Embedding 矩阵。进而输出 。接下来,进行归一化:
输出 后,进入 前馈神经网络, 模块混合且提取了大量的特征需要在 中理解,通过放到高维空间 形状为 ,从粗略管擦和到捕捉更复杂的特征,但是参数量过大,后面需要降维 形状为 ,而这个过程可能导致数值变化过大,因而需要加一个残差连接和归一化 和 。
至此,完成了整个 模块,输出一个形状为 的词向量矩阵 ,在 Encoder-Decoder 架构中,这回传递给 Decoder ,作为它的 K 和 V 。
进入 Decoder ,输入:[START, Yao, Ming, is, very, good, at, playing, basketball] 。这里第一个 和 几乎差不多,唯一的区别是这里 后需要和未来的词的相似度进行掩码操作,使得当前的词读不到未来的词的信息。(注意这里的 和 是独立的,并不是 ),进而得到输出 。进入第二个 ,这里要让此时的词看到中文的完整语义进而变成新的词向量,而后续的 会使得这个最后的词向量输出不断变成需要预测的下一个词,不过这些都是反向传播的力量,这里只是在搭框架。
此时的 和 都是 的输出 , 则是 上一个 传入,即拿着英文的语义去看中文语义和它的相似度,再变成概率最终乘以中文的语义,则得到的输出即是让中文能关注到和英文具有相同语义的特征,并通过残差连接,使得英文融入了中文的语义,也就是词向量发生了偏移,后面的 会使得词向量偏移偏向下一个正确答案。后面的和 中的一样,最后就可以输出一个融合了中文语义的词向量矩阵 。
对于这个词向量矩阵,这时候并不知道要输出哪个词,需要做一个映射 即有30000个模板做内积,并做 得到每个词的可能,挑出预测最高的词(这里学到后面可能和 有关),这时候就可以算 。这里补充一下,实际上我们不会只通过一个 和 ,而是各 个。
由于这个判断即多分类函数,所以由其最大似然估计,使用交叉熵作为损失函数。如下, ,后续的反向传播,则会使得输出不断往预测的下一个词,靠进而 , , 有了真实的含义。
现在来走一次完整的 反向传播:首先先是对词向量模板进行优化,使其尽可能提高预测正确的概率,其次修正 的思考向量,使得其提取出更能得出正确答案的向量。接着就会进入到 中去,先是 ,它原本是在512维的原本 token 大空间找一个小空间作为其语义空间,反向传播则是优化其语义空间,使其找到更好的语义空间,而 又是由 查询词向量 对应 的相似值概率的来,即上下文的相关信息,这里其实就是双线性映射,即在空间中找到两个语义空间使得其更好的提供有效的上下文信息。最后是到了 的修正不断使得相似语境的词靠近,反之疏远。
至此,搭建好了完整的中英文翻译,依赖 Encoder-Decoder 架构的神经网络模型。
虽然能理解模型是怎么运作的,但是对底层算子的设计这一块还是显得很局促。
Encoder-Only
(这个我后期再补,眼下重要的是会用下一个架构)
Decoder-Only
该架构即我们常见的生成式AI
同样的算子设计,不过这个模型变成纯预测,也就是一个自1注意力模型,只有一个 ,剩下的照旧。
一些补充吧
残差连接
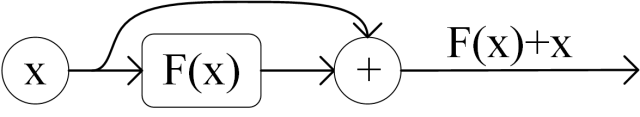
在ResNet中,有这么一种设计:当网络层数变深时,由于链式法则容易导致梯度传回浅层网络时已经很小,这使得浅层网络难以优化,这引发了另一个问题,当时的设计者不敢设计过深的网络,否则容易引起退化。为了解决以上问题,提出了残差连接:即在一些层中,这些层有着一个特点,即输入与输出的形状是一样的。我们会单独单独有一条特殊的通道,这里比喻作“高速通道”,使得前一层的输入可以直接传递给当前层的输出,使得当前层的最终输出变为:最终输出= + 。这样的设计使得 变成是对前一层的补充,让网络只关注当前差异的部分,而 保证了传递到浅层网络时的梯度,使得每一层都能很好的通过反向传播学习。即残差连接解决了网络无法设计的很深、浅层网络难以优化和网络设计过深会退化的问题。
而在工程中,一般会设计几个不同层数的 baseline 作比较,选出较好的层数。在现代神经网络设计,有了一种剪枝Stochastic Depth(随机深度) 或 LayerDrop(即可以使得模型中的一些层随机失活来检查某些层的有效性)
Teacher Forcing
这是自然语言处理(NLP)里训练序列生成模型(比如 Transformer 的 Decoder、RNN 等)时,最核心的一个“训练作弊技巧”。 如果训练时往模型输入的是上一次其自己推导的答案,容易导致一步错步步错,而每一次都直接喂正确答案但是给予对应的掩码既可以让模型尽可能的正确且实现并行计算